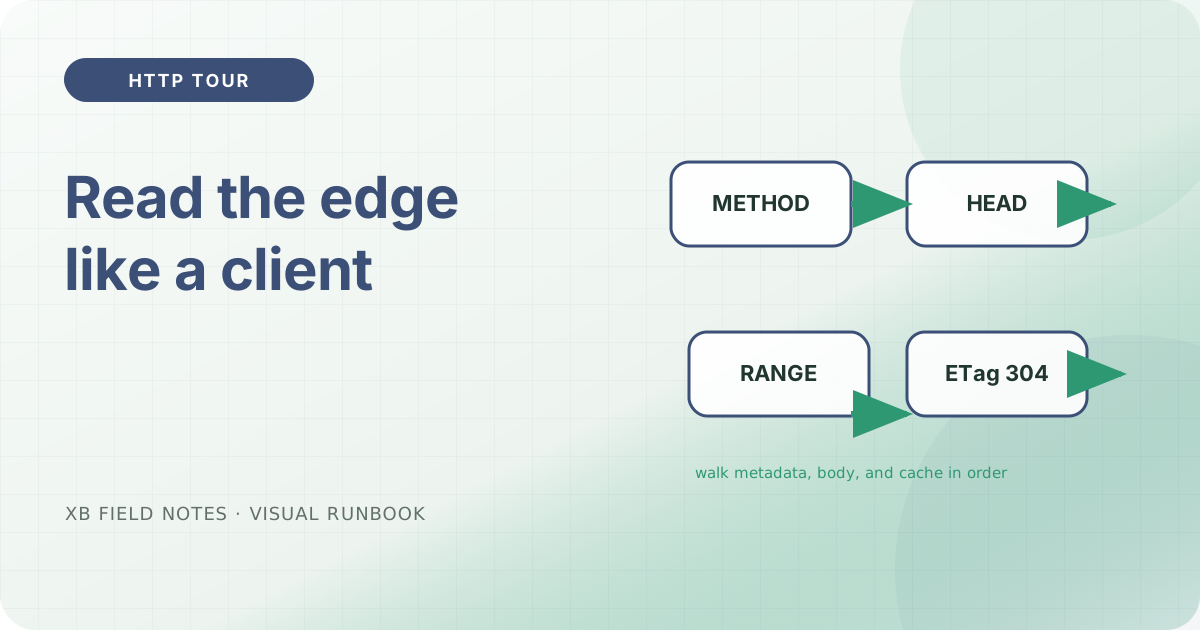
HTTP 基础篇的每条笔记各取一纸契约并展示单独的证据。本教程则按顺序走完一次客户端请求触达的完整路径,只用只读命令。到结束时,你已经在任何活动静态边缘上复现了那些笔记描述的检查——不改变它的状态。
我们全程用 www.xbcatm.com。把它换成你要检查的主机。下面每条命令都是只读的:读头部、请求元数据,或要求特定字节范围;没有任何一条会写入源站。
1. 先确定方法可以问什么
在读响应体之前,先确定服务器允许你问什么。静态源站没有事务,所以大多数会改变状态的方法都必须被显式拒绝。问边缘它允许什么:
$ curl -s -o /dev/null -w 'OPTIONS -> HTTP %{http_code}\n' -X OPTIONS https://www.xbcatm.com/
OPTIONS -> HTTP 405
405 Method Not Allowed 是诚实的答案。http-method-semantics 笔记解释了为什么这是静态源站应保持的契约:每个方法要么按文档化语义被支持,要么用表明拒绝的状态码回答。危险的失败模式是代理或导入的 handler 把被拒绝的方法转成静默的 200。如果你的边缘对 POST 也回 200,承诺就不再可见。
2. 读取表示行
第一行告诉你协商出来的交换;头部随后告诉你将要到达的是什么字节。像客户端看到的那样捕获它们、丢弃响应体:
$ curl -s -D - -o /dev/null https://www.xbcatm.com/
HTTP/2 200
accept-ranges: bytes
content-length: 15890
content-security-policy: default-src 'self'; base-uri 'self'; form-action 'none'; frame-ancestors 'none'; object-src 'none'; script-src 'none'; style-src 'self'; img-src 'self' data:
content-type: text/html; charset=utf-8
etag: "dkx84jwth7nkc9e"
last-modified: Mon, 24 Aug 2026 13:55:23 GMT
strict-transport-security: max-age=31536000; includeSubDomains
x-content-type-options: nosniff
三个头部值得停下来。content-type: text/html; charset=utf-8 命中了媒体类型,content-type-and-nosniff 说明为什么它必须描述你真正发送的字节。etag: "dkx84jwth7nkc9e" 交给你强验证器。x-content-type-options: nosniff 要求浏览器不要猜测类型。每一个都是证据而不是装饰,合在一起是说:这个边缘在你信任正文之前,就精确告诉你它的策略。
3. 确认 HEAD 等于 GET 但不带正文
HEAD 必须安全,并返回与 GET 相同的元数据,但不带正文。比较 HEAD 的 Content-Length(GET 会返回的字节数)与你真正 READ 到的字节:
$ curl -sI https://www.xbcatm.com/ | grep -i content-length
content-length: 15890
$ curl -s https://www.xbcatm.com/ | wc -c
15890
两者一致:都是 15890。这就是 head-request-parity 契约。若代理在 HEAD 上去掉或改写 Content-Length,这样一对检查就能抓住它。这正是 check-http-headers.sh 用 curl 一起读状态与头部、发布冒烟测试在替换前后比较 HEAD 的原因。
4. 用范围请求精确的字节
因为源站知道自己的表示,它可以只服务其中一部分。范围请求要求一个字节区间,只得到那个区间:
$ curl -s -o /dev/null -H 'Range: bytes=0-99' -w 'HTTP %{http_code} bytes=%{size_download}\n' https://www.xbcatm.com/
HTTP 206 bytes=100
对 100 字节区间给出 206 与 100 字节是诚实的结果。http-range-requests 笔记说明服务器如何选择字节、以及为什么需要强验证器。若服务器对任何范围区间都回 200 全量正文,那是另一种更昂贵的契约,也说明源站并不追踪你要的字节身份。
5. 用验证器让缓存重新验证
现在把方法、表示与字节选择通过缓存结合。存储副本只有在验证器仍然匹配时才是最新。把 ETag 条件式重放:
$ curl -s -o /dev/null -w 'HTTP %{http_code}\n' -H 'If-None-Match: "dkx84jwth7nkc9e"' https://www.xbcatm.com/
HTTP 304
304 Not Modified 只带极小的头部回复,告诉你所问的副本仍然是答案。这就是 conditional-requests 契约:验证决定存储副本是否新鲜;http-cache-headers 描述两个时钟——来自缓存头部的新鲜度,与来自验证器的正确性。304 从不是错误,它是"你已有正确的字节"的廉价说法。当 ETag 变化,下一次重新验证会返回新的 200。
6. 协商更小的表示
同样的内容在客户端表明能解压时可以传递更少字节。请求 gzip 并观察正文缩水而语义不变:
$ curl -s -o /dev/null -w 'no-enc: %{size_download} bytes\n' https://www.xbcatm.com/
$ curl -s -o /dev/null -H 'Accept-Encoding: gzip' -w 'gzip:   %{size_download} bytes\n' https://www.xbcatm.com/
no-enc: 15890 bytes
gzip:   4368 bytes
普通 GET 返回 15890 字节;gzip 协商对同一内容返回 4368。这是 http-compression-negotiation 笔记的核心:改变选中的表示会改变线上字节,元数据(content-length、encoding)也随之改变。请求压缩的客户端与存储编码形式的缓存必须就选了哪种表示达成一致,否则缓存会交付不匹配的结果。
7. 跟随 URL 变化时的故事
身份变化时,响应应说明故事在哪里继续,而不去猜正文:
$ curl -s -o /dev/null -w '%{http_code} -> %{redirect_url}\n' -I http://www.xbcatm.com/ | head -1
308 -> https://www.xbcatm.com/
308 Permanent Redirect 保持方法与故事,正是 redirects-and-status-codes 关心的。无论是永久移动的 301/308,还是由站点处理的 404,状态行都是故事的第一句,应在读正文前先读。
8. 最后让爬虫读地图
边缘也会被根本不请求 HTML 的机器读取。发现机制回答两个不同的问题,robots-and-sitemaps 有说明。确认发现机制指向真实 sitemap:
$ curl -s https://www.xbcatm.com/robots.txt
User-agent: *
Disallow:
Sitemap: https://www.xbcatm.com/sitemap.xml
一个在 robots、sitemap 与 HTTP 头部上都回答同一主机的主机,其操作者在发布前读过公共边缘。
所有检查一览
| 检查 | 证明什么 | 笔记 |
|---|---|---|
OPTIONS -> 405 | 源站拒绝不支持的方法 | http-method-semantics |
content-type + nosniff | 头部描述真实字节 | content-type-and-nosniff |
| HEAD == GET Content-Length | 安全、HEAD 一致 | head-parity |
| Range 0-99 -> 206/100 | 精确字节选择 | http-range-requests |
ETag -> 304 | 验证器决定新鲜度 | conditional-requests |
| 308 保留方法 | 重定向保留故事 | redirects-and-status-codes |
| robots -> sitemap | 发现答案不同 | robots-and-sitemaps |
每一行原来是一条笔记;现在是你可对任意边缘运行的命令。需要细节时读链接的笔记,把这个表留作再次检查时的速查。
来源
- RFC 9110 — HTTP Semantics,方法、验证器与状态码,已核验 2026-08-07。
- RFC 9111 — HTTP Caching,新鲜度与重新验证,已核验 2026-08-07。
- RFC 7538 — 308 Permanent Redirect,保留方法的重定向,已核验 2026-08-07。
- curl 手册,只读检查选项,已核验 2026-08-07。