这些笔记关注运维小型服务的枯燥部分:清晰的默认值、可观测的失败、可重复的发布,以及在真正需要之前就演练过的恢复。
当前合集围绕四个反复出现的问题组织:
- 协议或服务器到底承诺了什么?
- 哪些响应头、文件和日志让这个承诺可见?
- 哪些检查可以在不变更生产状态的情况下完成?
- 示例不够用时,应该去读哪份来源?
示例都刻意写得很小。请按你实际运行的环境调整路径、用户和策略。每篇笔记末尾都附带简短的来源列表,而不是把厂商文档抄进本站。
这些笔记关注运维小型服务的枯燥部分:清晰的默认值、可观测的失败、可重复的发布,以及在真正需要之前就演练过的恢复。
当前合集围绕四个反复出现的问题组织:
示例都刻意写得很小。请按你实际运行的环境调整路径、用户和策略。每篇笔记末尾都附带简短的来源列表,而不是把厂商文档抄进本站。
一个聚合摘要有用,但一份排序的逐文件清单能精确告诉你什么变了或丢了。
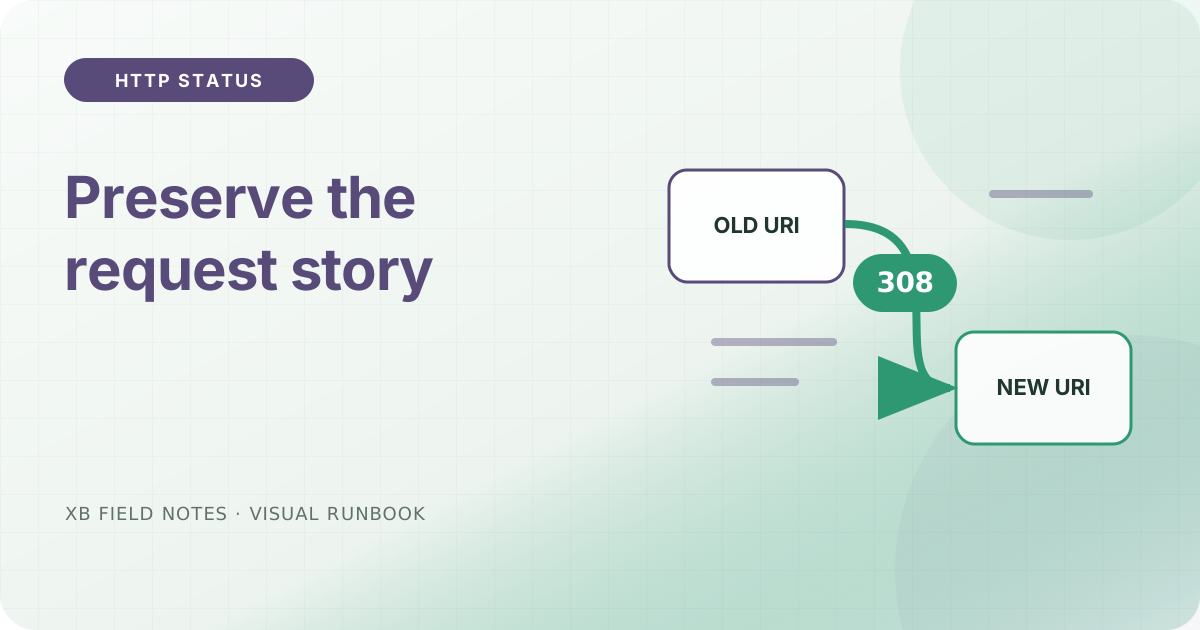
在选择重定向或错误状态前,先检查方法、Location 头与缓存行为。
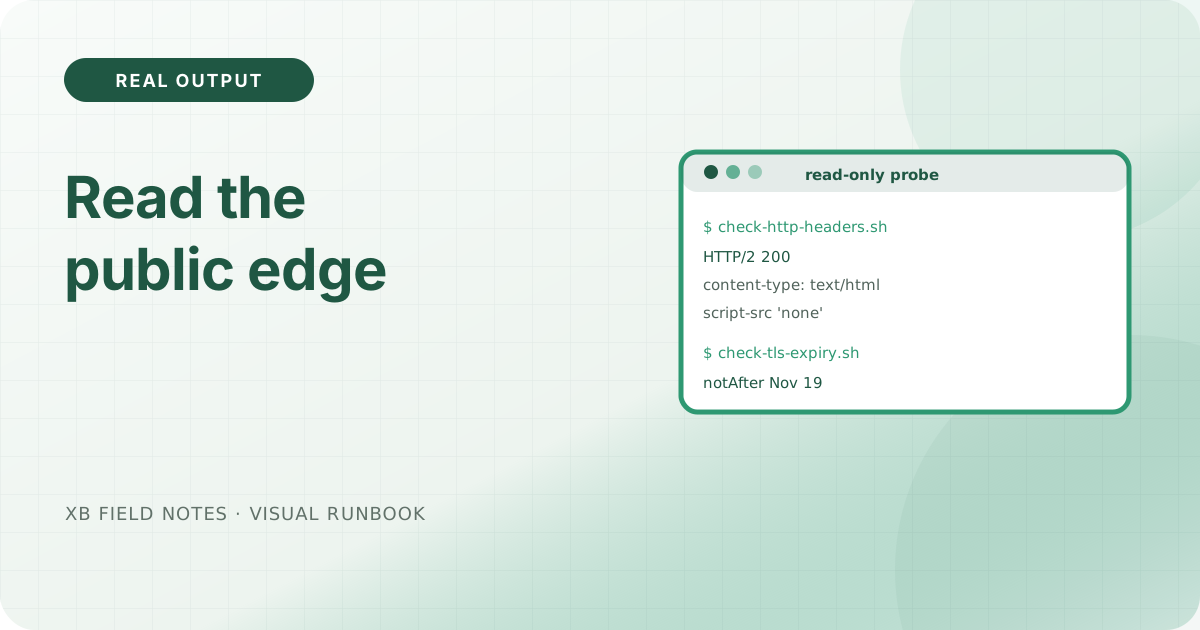
两个小的只读 helper 把公共端点变成发布前和发布后都能检查的证据。
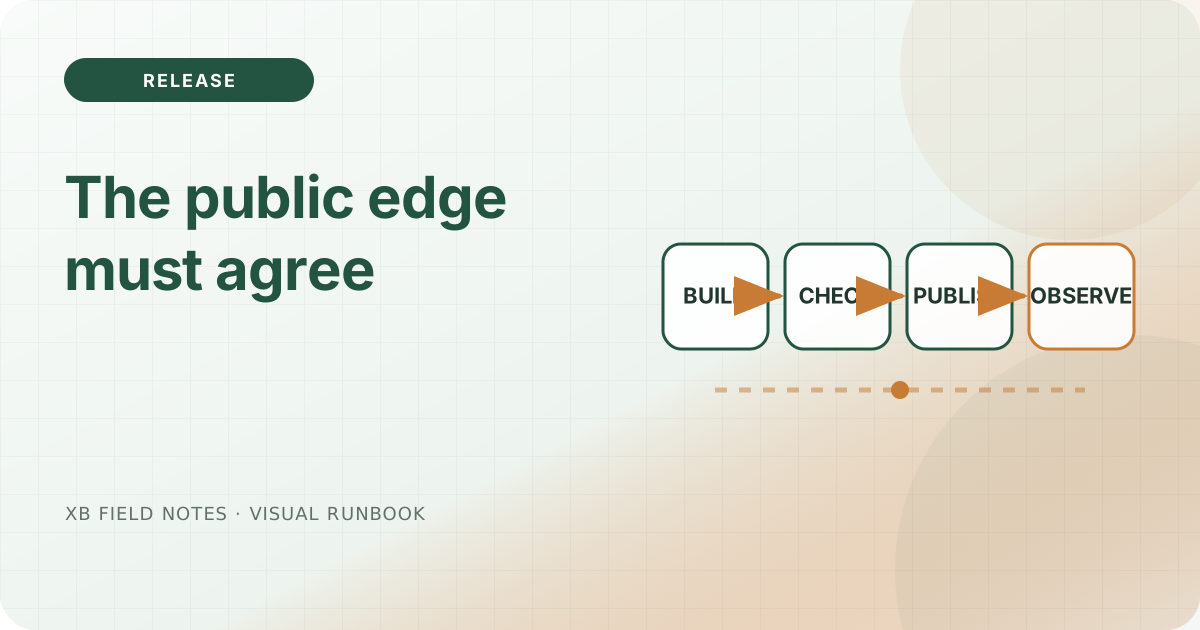
只构建一次,检视输出,然后在替换活动目录前请求代表性的公共路由。
复盘是一张从检测到症状到验证修复的顺序图,由产生每个事实的命令支撑。
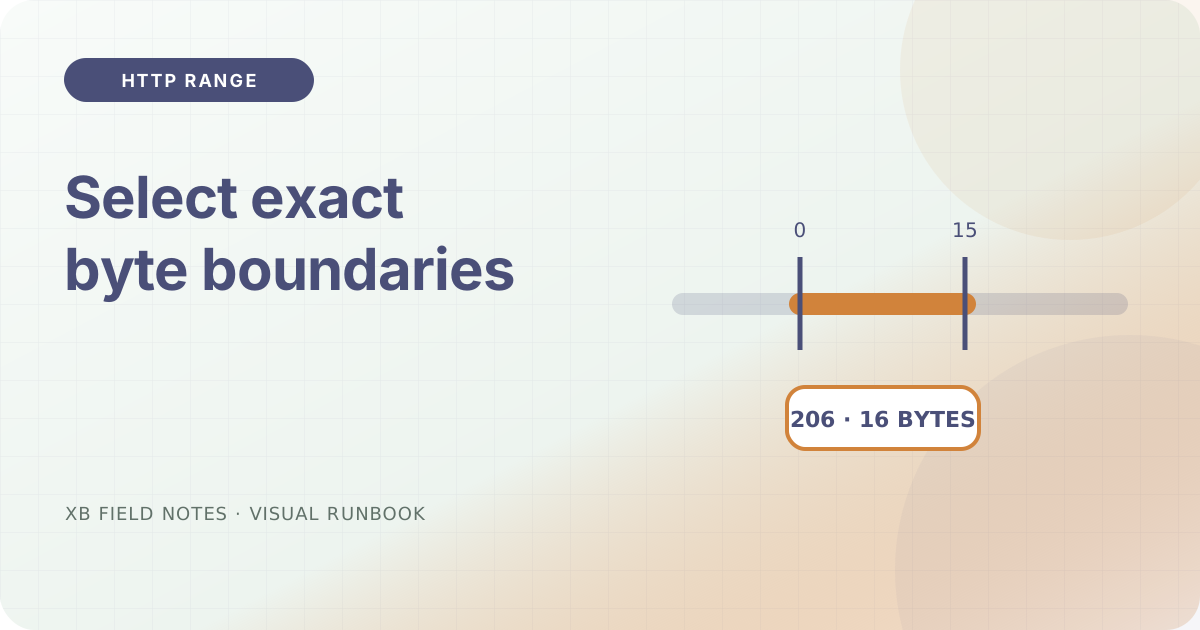
只有当 206 响应的边界与总大小描述了实际返回的字节时才有意义。
一次把方法边界搞清楚,OPTIONS、HEAD 与幂等写入就不再是意外。
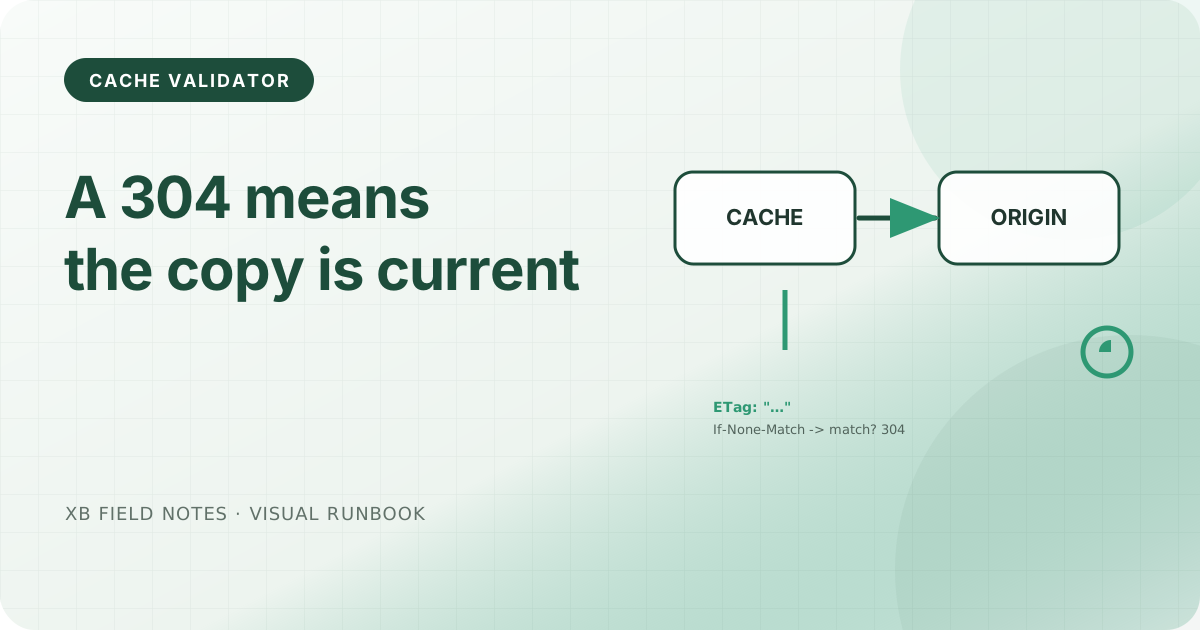
条件请求是缓存的第二个时钟;304 意味着存储的副本仍是答案。