这些笔记关注运维小型服务的枯燥部分:清晰的默认值、可观测的失败、可重复的发布,以及在真正需要之前就演练过的恢复。
当前合集围绕四个反复出现的问题组织:
- 协议或服务器到底承诺了什么?
- 哪些响应头、文件和日志让这个承诺可见?
- 哪些检查可以在不变更生产状态的情况下完成?
- 示例不够用时,应该去读哪份来源?
示例都刻意写得很小。请按你实际运行的环境调整路径、用户和策略。每篇笔记末尾都附带简短的来源列表,而不是把厂商文档抄进本站。
这些笔记关注运维小型服务的枯燥部分:清晰的默认值、可观测的失败、可重复的发布,以及在真正需要之前就演练过的恢复。
当前合集围绕四个反复出现的问题组织:
示例都刻意写得很小。请按你实际运行的环境调整路径、用户和策略。每篇笔记末尾都附带简短的来源列表,而不是把厂商文档抄进本站。
调度只是工作的一半,运维者还需要看到任务上次何时运行、如何结束。
使用显式的服务类型、有界的重启行为,以及在日志里留下证据的启动速率限制。
构建干净的制品,检查它而非仅源码,并记录结果供之后比较。
记录期望的指纹,使用斟酌过的 StrictHostKeyChecking 策略,并把变化当作事故来对待。
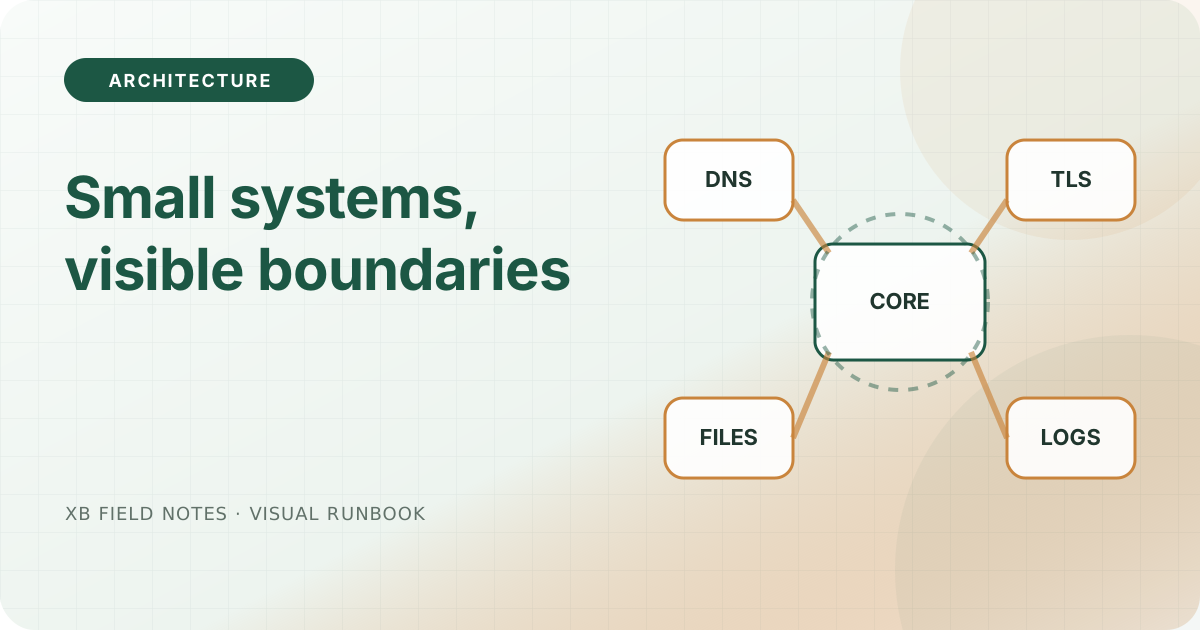
小不等于未完成;它意味着每个边界都有清晰的职责与可见的所有者。
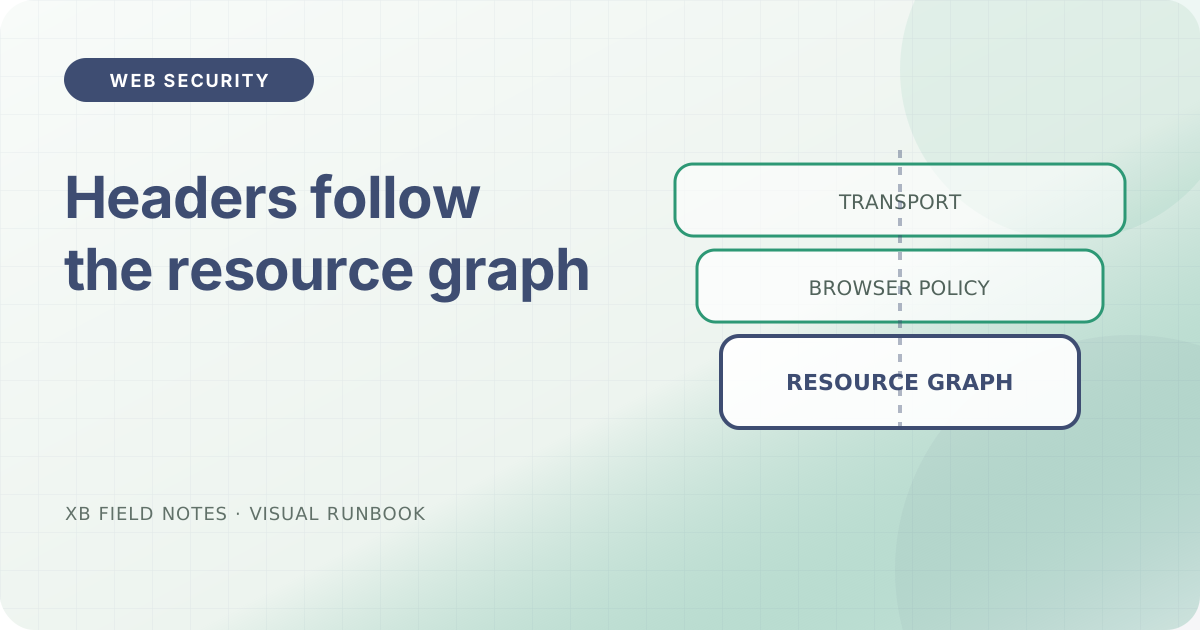
从窄策略开始,只在某个有文档说明的特性需要另一种资源时才扩大它。
robots.txt 是面向爬虫的偏好;sitemap 是 URL 清单;两者都不是授权层。
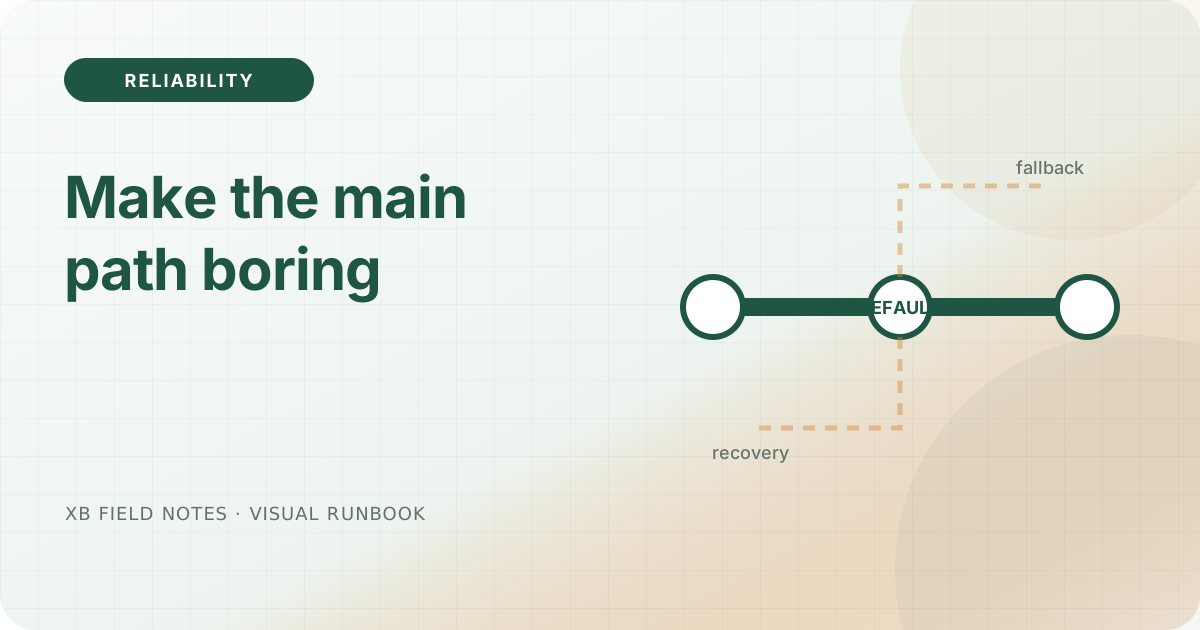
在添加恢复分支之前,让常见路径明确、可观察、且可安全重复。